ENG
AI Infrastructure

K-SMART AI SERVER

NVIDIA RTX PRO 6000 Blackwell 4장을 탑재한 GPU 서버
교육 · 연구 · 클라우드를 위한 AI 인프라를 설계부터 운영까지 함께합니다.

4GPURTX PRO 6000 Blackwell
384GBTotal GPU Memory
8PFLOPSAI Performance (FP8)
AI GPU SERVER MANUFACTURINGAI GPU 서버 제조RTX PRO 6000 기반 서버를 국내에서 조립 · 검증하고 직접 A/S합니다.
Why K-SMART

단말부터 서버까지,
한 곳에서 공급합니다

AI 인프라는 서버 한 대로 완성되지 않습니다. 학생이 쓰는 태블릿, 수업을 운영하는 소프트웨어, 그 뒤에서 연산을 담당하는 서버가 하나로 맞물려야 합니다.
K-SMART는 세 계층을 모두 자체 공급하고, 설치부터 A/S까지 단일 창구로 책임집니다.

LAYER 01

학습 단말

교육 환경에 맞춰 설계·생산한 스마트폰과 태블릿 PC.

  • 11" 교육용 태블릿 · 스마트폰 7종
  • MDM 내장 · KC 인증 완료
  • 액세서리 올인원 패키지 기본 제공
LAYER 02

교육 소프트웨어

수업 운영과 평가를 아우르는 통합 소프트웨어 계층.

  • MDM — 기기 원격 통합 관리
  • LMS — 학습 관리 · 집중 모드
  • AI Proctor — 온라인 시험 감독
LAYER 03

AI 인프라

모든 서비스의 연산을 담당하는 GPU 서버 계층.

  • RTX PRO 6000 Blackwell 4-GPU 서버
  • 1대 → 10대 클러스터까지 확장
  • 구축 · 운영 · 유지보수 일괄 지원

벤더를 여러 곳 상대할 필요가 없습니다. 도입 · 구축 · 교육 · A/S까지 K-SMART 한 곳에서 진행됩니다.

Product

4-GPU AI 서버

데이터센터용 패시브 GPU를 고밀도로 구성한 랙마운트 서버입니다.
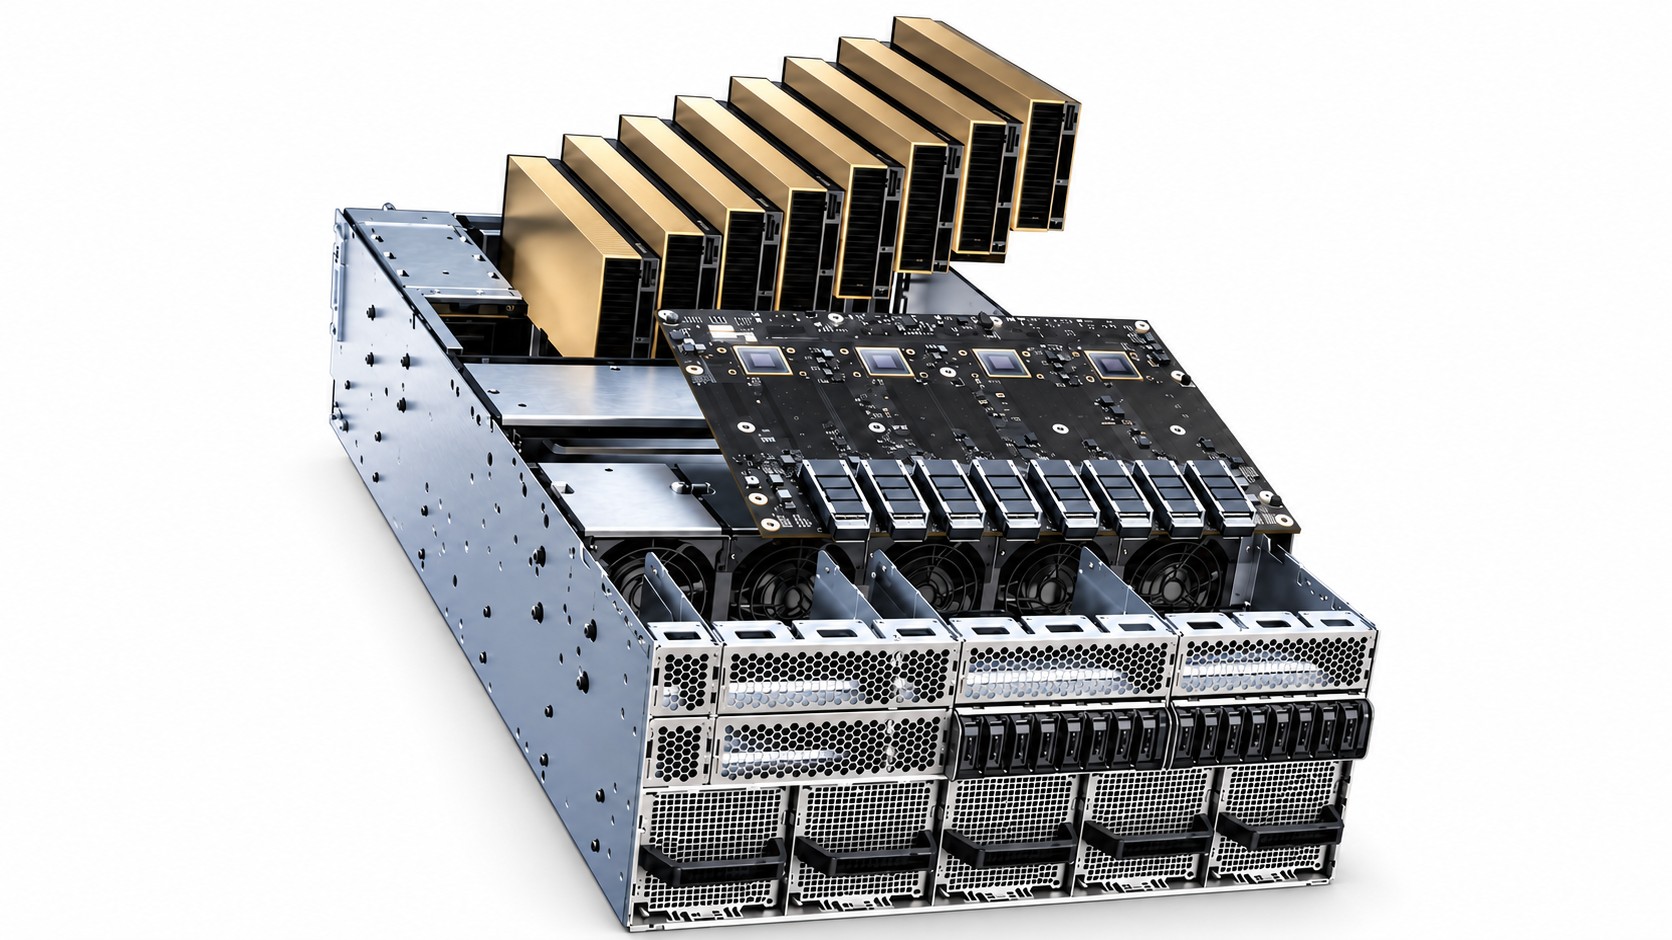
K-SMART AI SERVER — NVIDIA RTX PRO 6000 Blackwell 4장 탑재
NVIDIA Blackwell RTX PRO 6000 × 4 384GB GPU Memory

대규모 AI 학습과 추론을
한 대에서

NVIDIA RTX PRO 6000 Blackwell 서버 에디션은 멀티 GPU 서버 배치를 전제로 설계된 데이터센터용 패시브 GPU입니다. 장당 96GB GDDR7 ECC 메모리를 탑재해, 4장 구성 시 384GB의 대용량 GPU 메모리를 확보합니다. 대형 언어모델의 파인튜닝과 추론, 분산 렌더링, HPC 워크로드를 한 대에서 처리할 수 있습니다.

  • 압도적인 AI 성능FP8 기준 8 PFLOPS, FP4 기준 16 PFLOPS의 연산 성능
  • 대규모 병렬 처리4-GPU 병렬 구성으로 AI/ML 워크로드 가속
  • 유연한 확장성메모리 · 스토리지 · 네트워크 모두 확장 가능한 구조
  • 안정적인 운영이중화 전원과 패시브 냉각 설계로 24/7 무중단 운영
Specification

상세 사양

GPUNVIDIA RTX PRO 6000 Blackwell Server Edition × 496GB GDDR7 (ECC) / 장당 · PCIe 5.0 x16 · 패시브 냉각
GPU 메모리총 384GB (96GB × 4)
AI 성능FP8 8 PFLOPS / FP4 16 PFLOPSNVIDIA 공식 사양 기준 (장당 FP8 2 PFLOPS · FP4 4 PFLOPS)
CPUIntel® Xeon® Scalable Processors2 Socket 지원
메모리DDR5 RDIMM / 최대 2TB+
스토리지NVMe SSD / U.2 / SATA최대 30TB+ 구성 가능
네트워크10 / 25 / 40 / 100GbE 지원
전원Redundant Power Supply (80 PLUS Platinum)
폼 팩터4U Rackmount Server
냉각서버 섀시 프론트 → 백 에어플로우 기반 고성능 냉각 설계

1대 서버 GPU 구성

01RTX PRO 6000 · 96GB
02RTX PRO 6000 · 96GB
03RTX PRO 6000 · 96GB
04RTX PRO 6000 · 96GB
384GBTotal GPU Memory
Scalability

규모에 맞춰 확장합니다

1대에서 시작해 클러스터까지. 도입 규모에 따라 필요한 만큼만 구성하고, 이후 증설할 수 있습니다.

구성GPU 수량GPU 메모리주요 용도
1대 서버RTX PRO 6000 × 4384GBAI 학습 · 추론 · 연구개발
5대 클러스터RTX PRO 6000 × 201,920GB대규모 학습 · 교육기관 · 프라이빗 클라우드
10대 클러스터RTX PRO 6000 × 403,840GBAI 데이터센터 · 슈퍼컴퓨팅
1대 서버

연구실 · 학과 단위

오픈소스 LLM 파인튜닝, RAG 기반 챗봇 구축, 연구용 모델 실험에 적합합니다. 소규모로 먼저 검증해보실 때 권장합니다.

5대 클러스터

대학 · 교육기관 전체

다수 학과·연구팀이 동시에 사용하는 공용 AI 플랫폼, 학내 LMS·AI 감독관 서비스의 백엔드 인프라로 구성합니다.

10대 클러스터

국가 · 기업 데이터센터

국가 단위 교육 플랫폼이나 대규모 AI 서비스 운영을 위한 구성입니다. 네트워크·전력 설계부터 함께 진행합니다.

Use Cases

추천 활용 분야

동일한 하드웨어로 다양한 AI 워크로드를 소화합니다.

AI 교육

스마트 캠퍼스, 디지털 교과서 플랫폼, AI 튜터 서비스의 연산 기반

AI 연구

LLM 파인튜닝과 추론, 멀티모달 모델 학습, 벤치마크 및 실험 환경

클라우드

사내 프라이빗 클라우드, 가상 워크스테이션(VDI), AI 서비스 인프라

빅데이터

대용량 로그·센서 데이터 분석, 대화형 BI, 예측 모델 운영

도입 규모부터 함께 정리해 드립니다

워크로드와 예산에 맞는 구성을 제안하고, 설치·구축부터 운영 교육과 유지보수까지 지원합니다.
구성 상담과 견적은 아래로 문의해 주세요.

Emailaligo9799@gmail.com Head Office경기도 파주시 교하로 1359-1, 1,2동 일부